我要认证
2026-11-09 阅读量:8
真实案例:标书改了十几版,评分却几乎没有变化,白白浪费Token
某企业正在准备一份重要项目的投标文件,团队搭建了一个招投标答标Agent,希望它能够自动检索招标要求、生成答标初稿、根据评分标准进行质量评估,并在分数偏低时自动重写。
系统运行初期,Agent 能够完成资料检索和初稿撰写,评分模块也能指出部分问题。但进入自动重写环节后,团队发现系统经常陷入循环:第一版被评为 58 分,重写后变成 60 分,第三版又回到 59 分。每一版的措辞看起来有所不同,技术方案、实施计划和招标条款响应等关键内容却没有明显改善。
Agent 仍然根据“评分低于标准”这一结果继续重写,缺少对上一轮失败原因的深入整理。随着循环不断运行,历史稿件和生成内容持续增加,Token 预算逐渐被消耗,最终任务可能在没有产出合格答标稿的情况下中止。
这个问题的核心在于,评分结果没有被转化成下一轮明确的修改动作。模型知道当前稿件分数不够,却未必清楚具体哪个章节失分、缺少什么证据、应该补充哪些内容。
解决办法:在每轮重写前增加一个反思节点
首先,保留上一轮的评分反馈和修改记录。评分模块除了给出总分,还应尽量提供分项得分、未满足的招标要求、缺失证据和具体扣分原因。系统可以保留最近几轮的修改摘要,方便后续分析问题是否重复出现。
让反思节点识别真正的失分原因。反思节点读取当前答标稿、评分反馈和历史修改记录,归纳哪些问题仍未解决,哪些修改没有带来改善,以及哪些章节存在重复或偏离招标要求的内容。它需要给出具体依据,避免只输出“内容不够完善”“需要进一步优化”这类笼统判断。
生成可执行的修改计划。计划应明确修改位置、当前问题、目标要求、具体动作和所需材料。例如,技术方案章节缺少与招标参数逐项对应的说明,就应补充参数响应表和实现依据;实施计划缺少验收节点,就应补齐阶段安排、交付物和验收标准。
根据计划进行定向重写。改稿节点接收反思节点输出的计划,优先修改明确指出的问题章节,并保留已经符合要求的内容。对于需要补充的技术参数、资质证明或案例材料,如果输入资料中没有提供,应标记待补充,避免模型自行编造。
重新评分并比较变化。新稿生成后,再由评分模块检查各项要求是否得到改善。系统需要对比本轮与上一轮的分项得分、问题数量和修改结果,判断计划是否真正解决了原有问题。如果某项问题持续未改善,就应重新分析原因,而非机械重复相同指令。
设置合理的停止条件。工程实践中还可以增加最大重写轮数、Token 预算、最低合格分数和连续无提升停止规则。达到合格标准后结束;连续几轮没有有效提升时暂停自动重写,交由人工检查。反思节点负责提高修改质量,停止条件负责限制循环成本,两者配合更稳妥。
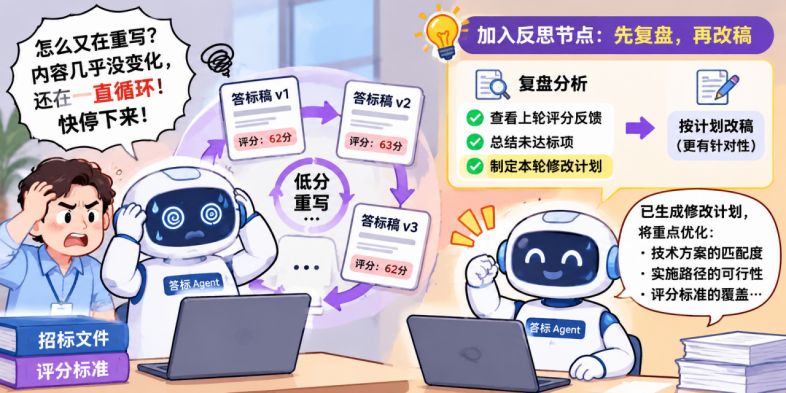
从实际效果来看,反思节点需要让Agent 回答三个具体问题:上一版哪里没有达到要求?这些问题为什么没有被解决?下一版准备在哪些位置采取什么修改动作?当这三个问题有了明确答案,重写才有可检查的方向。
将真实场景转化为一道CAIE 练习题
某招投标答标Agent 包含“检索招标要求 → 写初稿 → 质量评分 → 低分则重写”的循环。实际运行中经常出现内容变化很小却无限重写,直到 Token 耗尽。要优先降低这种死循环风险,最有效的措施是:
A. 在每轮低分后强制提高 Temperature 并切换不同采样组合,用输出多样性去“冲破”重复状态。
B. 在重写前增加一个反思节点,让模型先读取历史修改记录和评分反馈,输出具体修改计划,再基于该计划改稿。
C. 把所有历史失败稿和评分意见全文回灌给模型,让它在更大的上下文里自己总结下一版怎么改。
D. 在系统提示词中加入更强的失败惩罚,例如“连续低分视为严重错误,必须彻底重写结构”,以此让模型主动避免重复。
答案解析:B
B 正确:反思节点会先读取上一轮的评分反馈和修改记录,分析哪些问题没有解决、哪些修改没有产生效果,再输出明确的修改计划。后续改稿围绕计划执行,每一轮都有具体目标和可检查的动作,因此能够减少机械重复。
排除A:提高 Temperature 或调整采样组合可以增加生成内容的多样性,但不同写法并不意味着更符合招标评分标准。如果模型没有理解上一轮的失分原因,输出变化仍可能停留在措辞层面。
排除C:增加历史上下文能够提供更多信息,但把所有失败稿全文回灌会增加上下文负担,也可能让模型重复关注大量相似内容。如果没有先提炼出关键失败点和修改方向,下一轮仍可能缺少针对性。
排除D:系统提示词中的严厉要求可以提醒模型重视评分结果,但语气更强并不能自动形成具体的修改策略。模型仍可能反复执行“彻底重写”的笼统指令,无法保证真正修复评分反馈指出的问题。
这道题对应的能力:理解Agent 的反思与迭代优化机制
从CAIE LEVEL Ⅰ 的学习与实践角度看,这个场景可以联系 Agent 工作流设计、反馈利用和结构化任务拆解能力。一个包含检索、生成、评分和重写的 Agent,已经具备基本的任务循环;要让循环持续产生价值,还需要把每轮执行结果转化成下一轮可用的信息。
反思节点承担复盘和计划制定任务:读取历史结果,识别当前差距,提出具体修改动作。改稿节点再按计划执行,评分节点负责验证改动是否有效。这样的设计让反馈真正参与后续决策,也更容易定位循环中的问题。
提示词示范:让Agent 在重写前先做一次反思
你是招投标答标Agent 工作流中的反思节点。请阅读当前答标稿、上一轮质量评分反馈,以及最近几轮修改记录。
本节点暂时不要直接重写全文,请先完成复盘并输出本轮修改计划。
请按以下结构分析:
1. 未达标项:列出评分低于要求的具体维度,并引用对应的招标条款或评分标准。
2. 问题定位:指出当前答标稿中对应的章节、段落或缺失内容。
3. 历史修改检查:说明上一轮已经修改了什么,哪些问题仍然存在,哪些修改没有带来有效提升。
4. 修改计划:逐项列出修改位置、具体修改动作、需要补充的材料或证据,以及预期改善的评分维度。
5. 保留内容:指出已经满足要求、无需重复改写的章节。
6. 待确认事项:如果缺少资质、技术参数、项目案例或其他事实材料,请明确标记待补充,不得自行编造。
输出要求:修改计划必须具体、可执行、可验证,避免使用“进一步优化”“提升质量”等笼统表述。完成计划后,将其交给改稿节点执行。
当前答标稿:{当前版本}
评分反馈:{本轮评分与扣分原因}
历史修改记录:{最近几轮修改摘要}
招标要求与评分标准:{招标文件相关内容}
这段提示词专门用于重写前的反思环节。实际工作流中,可以把反思节点的输出保存为结构化修改计划,再传给改稿节点;改稿完成后,将新评分和修改结果回传,供下一轮反思使用。这样每次迭代都有明确的依据,也方便团队追踪Agent 为什么做出某项修改。
结语
招投标Agent 的自动重写能力,最终要看每一轮是否真正解决了评分反馈中的问题。加入反思节点后,系统可以先复盘失败原因,再制定具体计划,随后执行定向修改,并通过新一轮评分验证结果。配合最大轮数、预算和无提升停止规则,能让自动答标工作流更加可控。
如果你也想系统提升自己拆解Agent 工作流、设计多轮任务和优化 AI 自动化流程的能力,可以点击下方小程序,完成一次 AI 应用能力测评,了解自己的能力特点,并获取相应的学习路径建议。
👉 完成测试后,还可领取 《 CAIE LEVEL 考试大纲》 与更多实战练习题
上一篇: AI 知识库运营专员岗位解析