我要认证
2026-11-18 阅读量:8
真实案例:从批量工单标注到重大决策,如何把模型用在刀刃上
某企业准备升级内部 AI 平台,业务部门提出四类需求:售后团队要给数十万条工单自动分类;法务团队要交叉审查重大投标文件中的责任与免责条款;投资团队要核对并购测算中的利润、协同假设和现金流;战略团队则要推演“若市场份额下降 10%,当前判断是否仍成立”。
试点发现,推理模型适合复杂文件审查和战略分析;但若所有工单也交给它,调用费用和处理时间会快速增加。企业真正需要的不是全员使用最强模型,而是在达到质量要求的前提下,让任务匹配合适的模型。模型选型不能只看排行榜,还要综合任务复杂度、错误代价、处理规模、响应时限和单位任务成本。
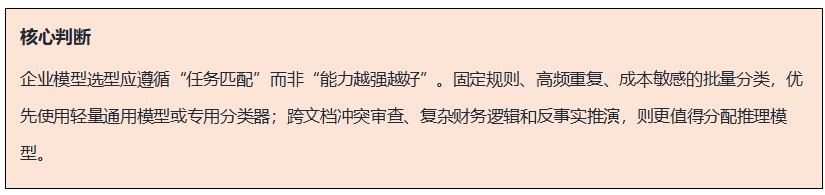
通用模型更适合指令明确、步骤较少、格式固定的分类、提取和常规问答。推理模型会投入更多计算来拆解问题、比较路径、处理歧义并完成多步判断,因此更适合跨材料核对、因果分析和复杂规划。两者不是简单的好坏之分,而是面向不同工作负载的取舍。成本不只体现在模型单价。推理过程会产生额外 reasoning tokens,占用上下文并计入输出用量,也可能增加等待时间。OpenAI 文档说明推理 token 会计入输出 token 费用,并建议按任务复杂度调节推理强度。对固定规则、高频重复的分类任务,昂贵的深度推理通常没有必要。
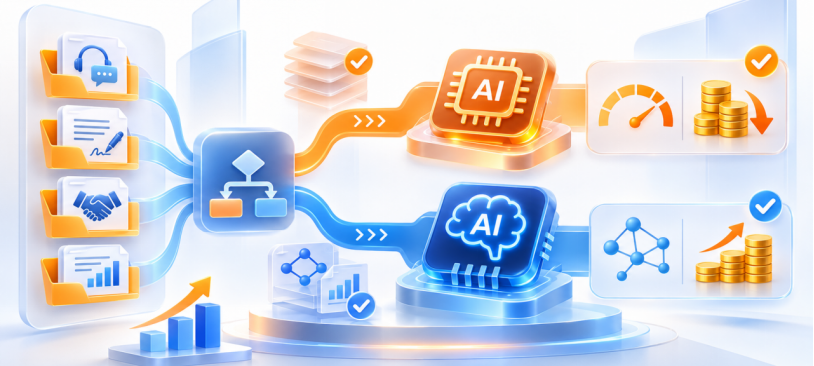
解决方案:建立分级路由,让模型按任务复杂度接单
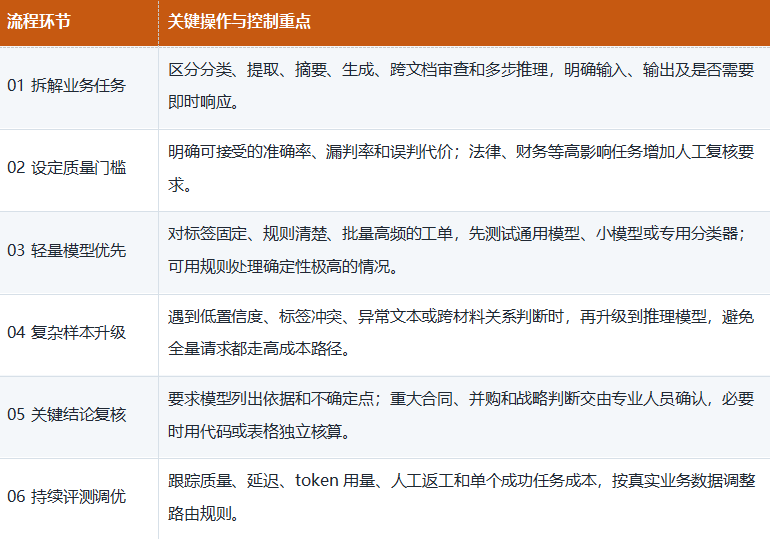
建议采用“任务识别—轻量模型优先—复杂任务升级—结果抽检—持续评估”的流程。先区分分类、提取、跨文档审查和复杂推理,再按质量、风险与时效分配模型。Google Cloud 也建议将结构化分类交给小模型,把复杂推理留给更强模型,并动态路由。
容易忽略的细节
·通用模型并非只能做简单任务。标签清楚、样本稳定时,轻量模型或传统分类器都可能胜任;部分平台还允许在同一模型上调节推理强度,因此应比较具体模型与配置,而不是只看名称。
·批量处理与模型能力是两件事。若工单不要求即时返回,可考虑异步批处理。OpenAI Batch API 将大规模数据分类列为适用场景,并提供相较同步接口 50% 的费用折扣和最长 24 小时的完成窗口;这只是特定平台的例子。
·高风险任务也不是交给推理模型就万无一失。模型可协助定位合同冲突、财务假设和战略风险,但不能代替律师、财务顾问或管理层作最终判断。
将真实场景转化为一道 CAIE 练习题
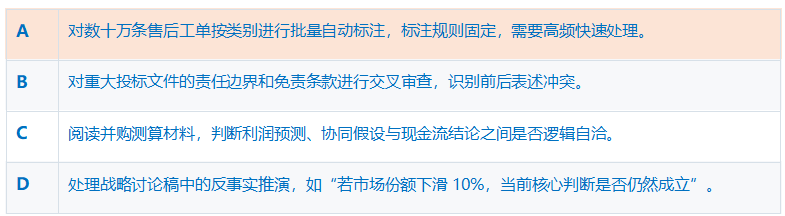
作为企业 AI 架构负责人,你需要在有限预算下为不同业务场景选择模型。现有通用模型(响应快、成本低)和推理模型(深度思考、成本高、延迟高)。管理层要求把高推理成本用在真正值得的地方。以下哪个场景最不适合直接使用推理模型?
答案解析:A
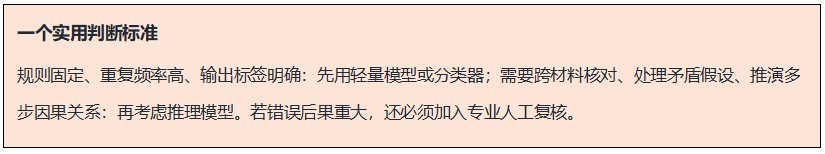
A 正确。数十万条售后工单的批量标注,特征是“规则固定、高频重复、成本敏感”。任务通常只是把文本映射到预设类别。只要分类标准清楚、边界样本经过验证,轻量通用模型或专用分类器就可能胜任。全量调用高成本推理模型,通常难以获得相称的收益。
B、C、D 都需要判断多项信息之间的关系,而不只是识别固定标签:包括条款冲突、财务假设逻辑和反事实情景的连锁影响,因此更值得评估推理模型。它们提供的是决策支持,不是最终专业结论。
A 并非永远不能升级。遇到复杂争议、重大损失或低置信度工单,可先轻量分类,再把异常样本交给推理模型或人工处理。题目不适合的是“直接将全部工单交给推理模型”。
逐项排除
排除 B:跨章节审查责任与免责条款,需要识别例外条件和前后冲突,属于多步文本分析。
排除 C:并购分析要核对利润预测、协同假设和现金流之间的逻辑关系,不只是读取数字。
排除 D:反事实推演需要改变变量并分析其对市场、收入和战略判断的连锁影响,体现多步情景分析。
这道题对应的能力:从会调用模型,到会设计模型路由
考查的是能否识别任务认知负荷,并在质量、成本、速度和风险之间合理配置模型。
任务分级:区分分类、提取等规则明确任务,以及跨文档审查、因果分析等复杂任务。
模型路由:常规请求走轻量路径,低置信度、异常或多步分析任务再升级。
评测度量:同时比较准确率、漏判率、P95 延迟、人工返工率和单个成功任务的总成本。
风险治理:为法律、财务和战略等高影响场景设置证据引用、人工复核和审计记录。
成本运营:持续监控调用量、推理 token、重试和升级比例,定期调整路由阈值。
实战提示词:先判断任务,再决定调用哪类模型
下面的提示词可用于初步分流。生产环境也可先用规则或轻量分类器路由,再将不确定样本升级。
模型路由指令
模型上线评估指令
结语:不是模型越强越好,而是每一分推理成本都要花得值得
企业 AI 架构的目标,不是让所有业务都使用最强模型,而是在质量达标的前提下,把合适的任务交给合适的模型。批量固定任务走轻量路径,复杂判断再调用推理模型,高影响结论保留人工复核。模型分级、动态路由与持续评测结合,才能让每一分推理成本都花得值得。 完成作答本身就是进步。
👉 完成测试后,还可领取 《 CAIE LEVEL 考试大纲》 与更多实战练习题
上一篇: 新兴岗位解析:AI 市场研究分析师 下一篇: 美联储主席重磅发声:AI能带来三种经济大结局