刚刚,谷歌发布Gemini 4 Neon!今日全球上线,超越GPT-6.2 Sol
2026-11-19 阅读量:6
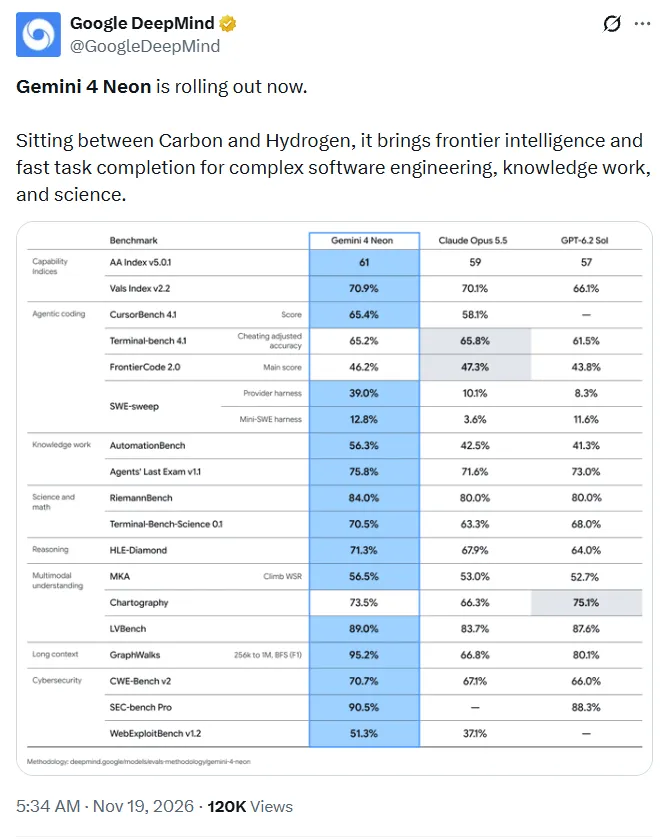
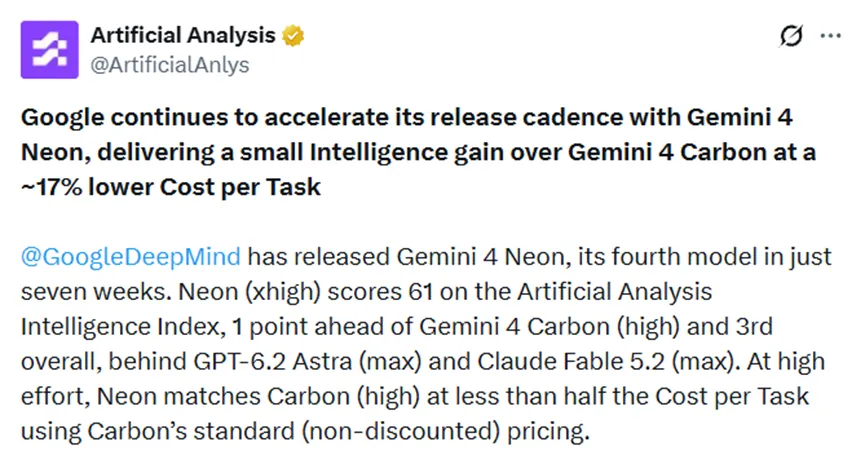
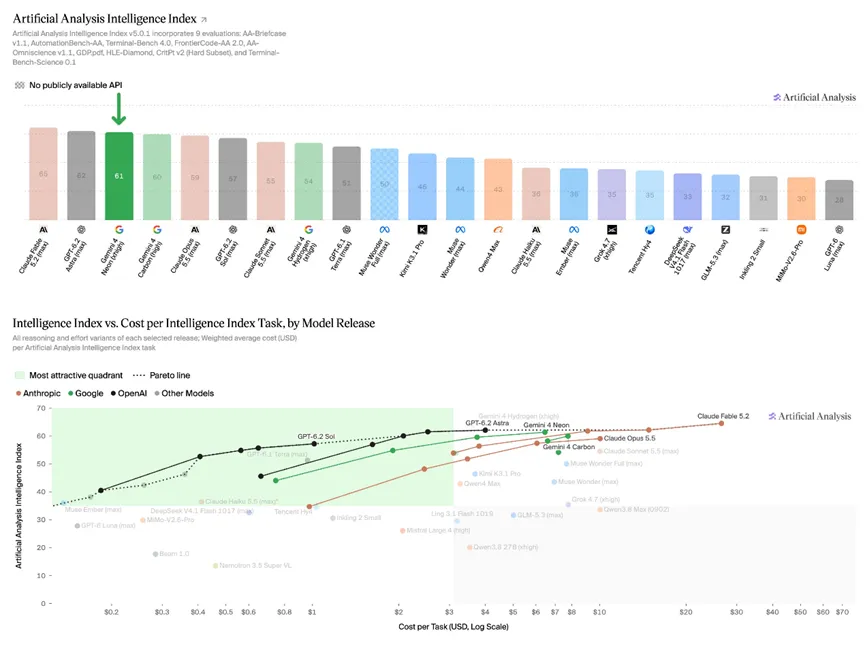
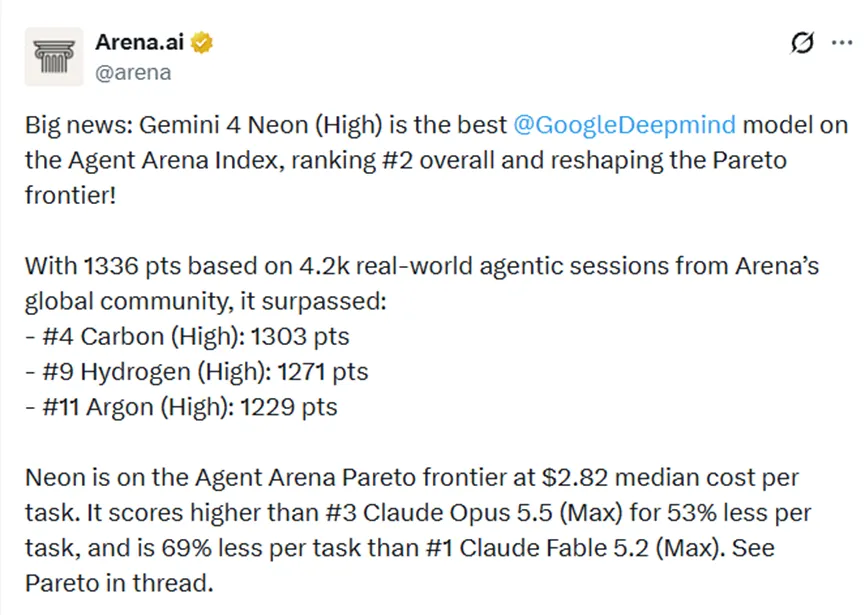
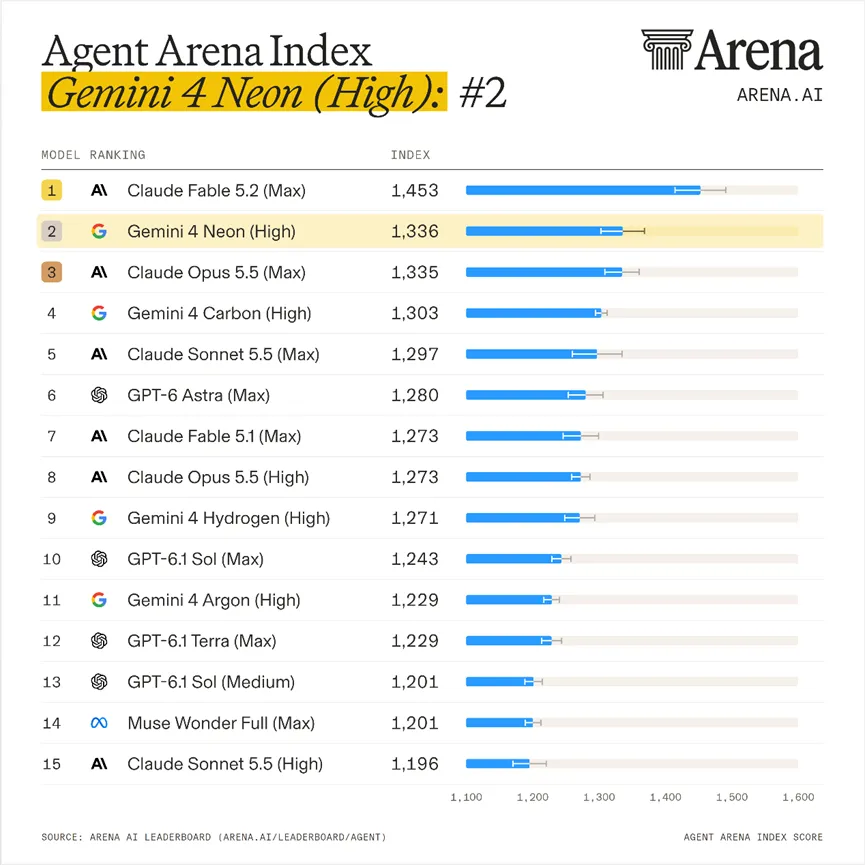
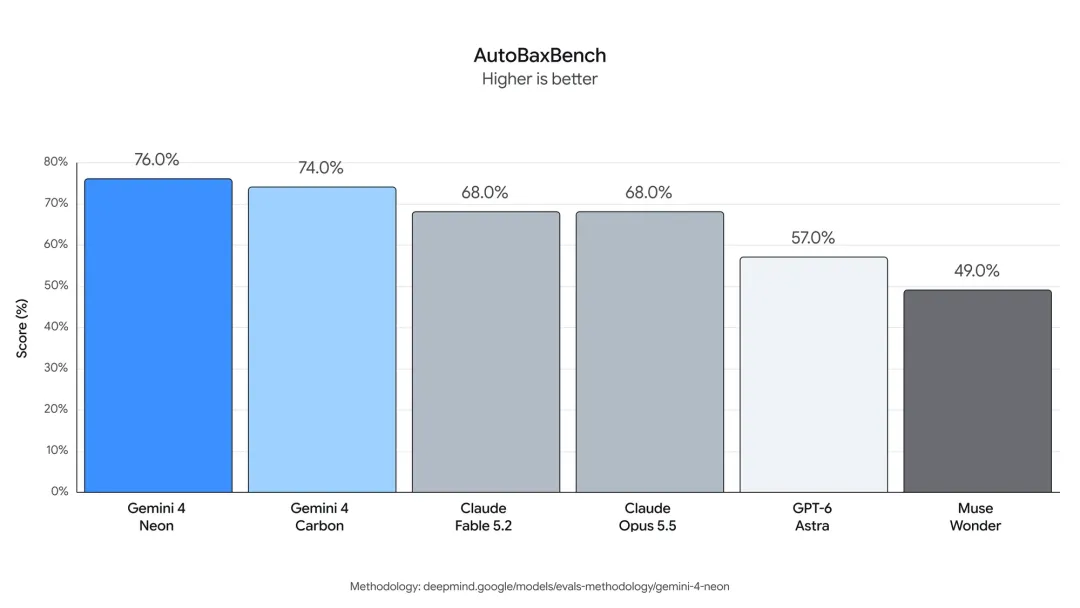
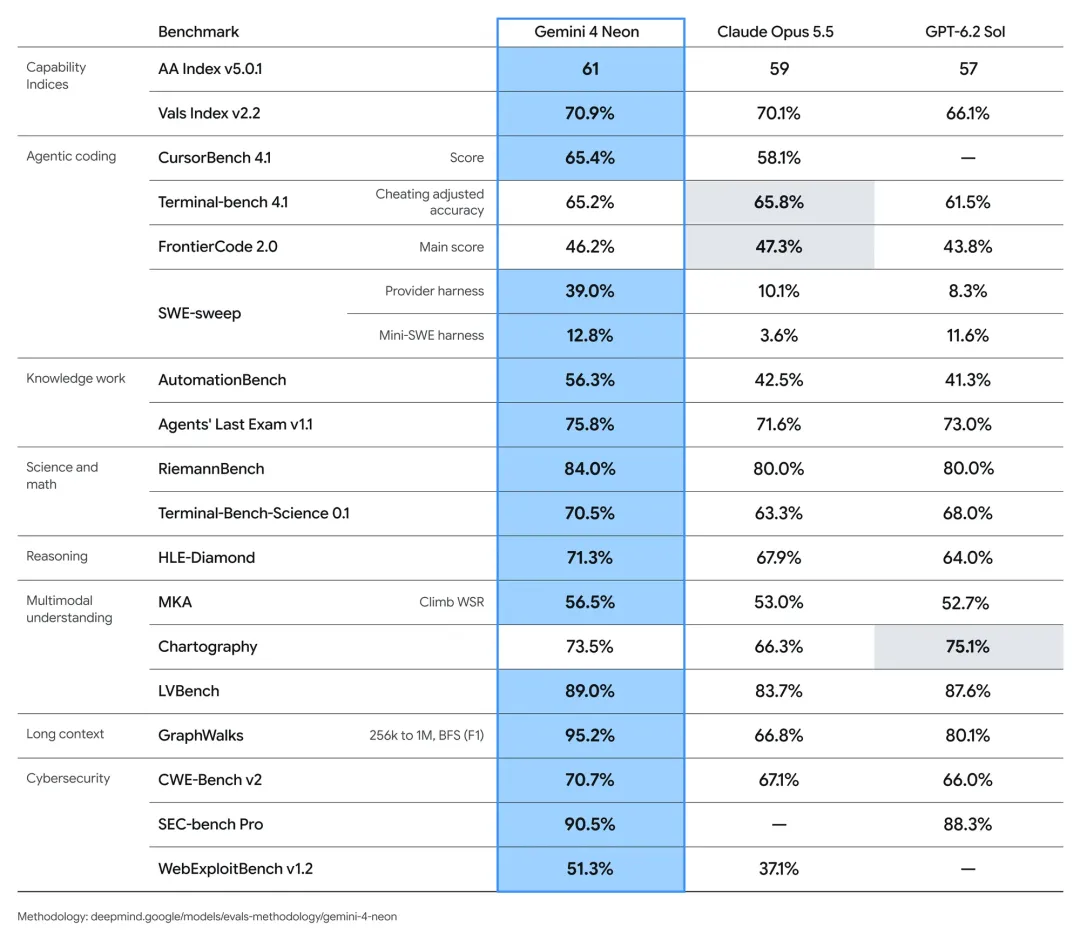
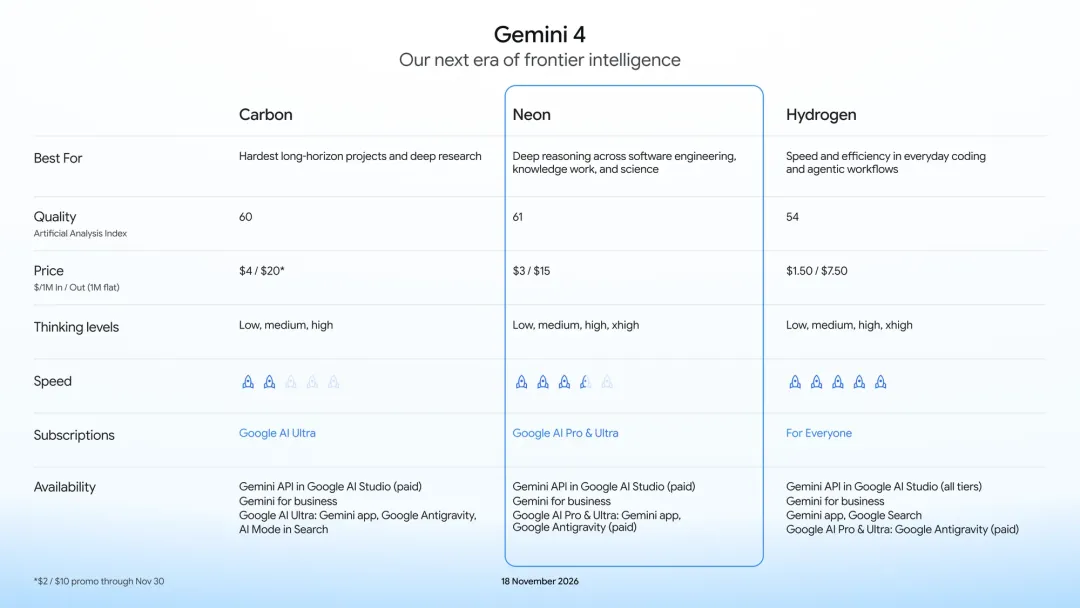
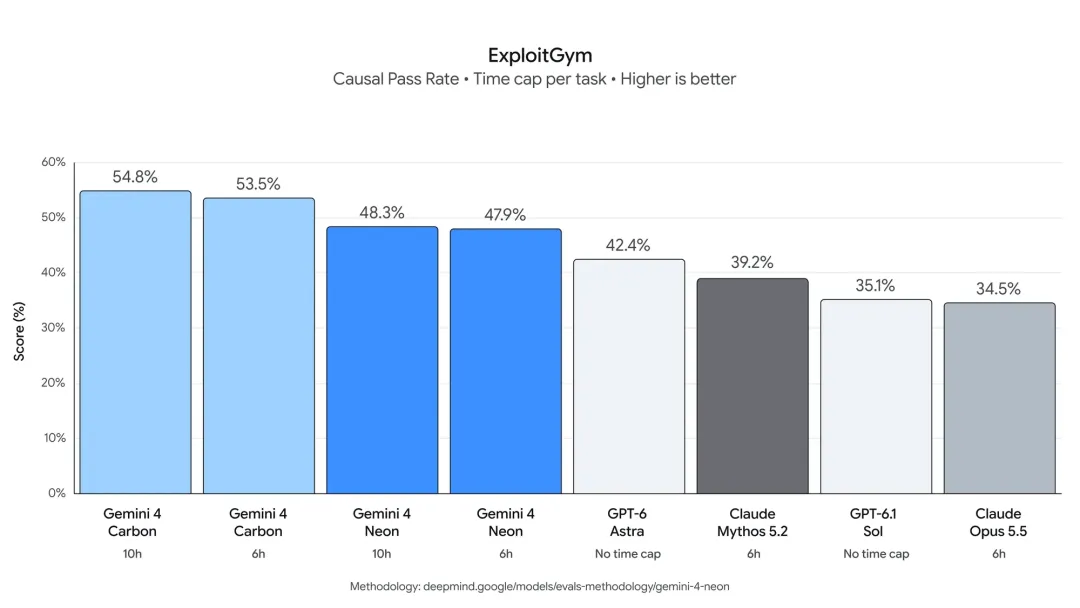
今天凌晨5点30,谷歌重磅发布了最新旗舰模型Gemini 4 Neon。根据官方测试数据显示,Neon在智能体编程、知识工作、深度推理、多模态理解等15项主流测试中,超过了OpenAI刚发布的GPT-6.2 Sol。价格方面也相当能打,每百万输入token为3美元,缓存输入只要0.15美元,输出为每百万token为15美元。从今天开始,Google AI Pro和Ultra订阅用户可以在Gemini应用和AI Studio中体验了。开发者可以通过Gemini API、Vertex AI和AI Studio使用。知名大模型竞技场Artificial Analysis刚刚也放出了最新排行榜,Neon整体排名第三,仅次于Claude Fable 5.2 (max)和GPT-6.2 Astra (max)。Neon在高档位推理模式中性能大幅度增强,但成本还不到Gemini 4 Carbon的一半。在基于Arena全球社区4,200多次真实AI智能体会话的测试中,Neon以1336的高分位列第二。更亮眼的是成本控制,Neon凭借仅2.82美元的单任务中位数成本,稳稳站上了Agent Arena的帕累托前沿。对比顶级闭源模型,其性价比优势非常直观。Neon的得分反超了排名第3的Claude Opus 5.5 (Max),但单任务成本足足便宜了53%;即便是对比排名第一的Claude Fable 5.2 (Max),它的单任务成本大幅降低了69%。用Neon和Fable 5.2开发一个相同的类王国战争小游戏,Neon的效果明显更好。Neon在Google Antigravity环境内执行了一个长达12小时的AI智能体集群任务。需要根据历史档案照片,把艾伦·图灵1936年的书房重新构建出来。而整个重建过程的核心亮点在于,在还原的3D场景中,完整复刻了一台正在运行的通用图灵机,也就是现代计算机的最初蓝图。使用Opus 5.5 和Neon相同的提示词开发一款像素游戏,从数据来看,两者耗时相近,但成本差异悬殊。Neon耗时20分钟,仅花费约3.5美元;而Opus 5.5虽然快了2分钟,费用却是7.2美元是Neon的两倍多。更关键的是产出质量,Neon所补充的细节极其出色。从上面的展示案例不难看出,Neon这次的代码能力非常突出。其实Neon就是冲着长时间运行的AI智能体工作流设计的,在复杂大量调工具的任务里从头到尾保持性能。独立跑也行,在Antigravity里当快速高判断力的编排器也行,调度并行的Hydrogen子智能体。在Artificial Analysis编程智能体指数综合第一58.6,Terminal-Bench 4.1拿65.2%,FrontierCode 2.0默认高推理档位46.2%。跨仓库多文件调试和重构能做,外科手术式修改也精准。SWE-sweep在Mini-SWE测试框架上12.8%领先,在Antigravity里直接冲到39.0%的最先进水平,这差距说明测试框架本身也在释放模型潜力。几个演示也挺能说明问题。它能在 Antigravity 里用 /swarm 命令驱动 Blender MCP,把 Gemini 4 家族模型用化学元素的方式可视化出来;也能从零写一个基于真实地形的 WebGL2 自由式滑雪模拟器,包含 10200 行自定义着色器、120Hz 滑雪物理引擎、动态滑道、雪崩和空间音效,而且没有使用预制素材;甚至能把一张图片转成包含 10 万个单元格的 Google 表格,用超过 50 万个实时公式完成边缘检测、3D 深度映射和多光照重建。企业里大量工作其实都散落在电子表格、PDF、图表、音频和视频里。Neon 的优势在于能把这些东西一起丢进同一个 100 万 token 的上下文窗口,然后输出成结构化的结果。独立评估里,它在 Vals 指数上拿到 70.9%,排第二;在 Legal Research Bench 和 Tax Agent Bench 上都排第一。在金融、会计、电子表格建模和复杂约束遵循这些类别里表现也很突出,多数基准排第一。Chartography 这种专门测密集专业图表阅读能力的测试,拿到 73.5%。Agents' Last Exam v1.1 上拿到 75.8%,和领先模型基本持平。Zapier 的 AutomationBench 上它排第一,Andon Labs 的 Vending-Bench 2 这种长周期商业运营模拟也排第一。Agent Arena 指数覆盖 4200 多次真实智能体会话,Neon 首次亮相就拿到 1336 分,全球第二。科学和数学推理方面,它在Terminal-Bench Science 拿到 70.5%,RiemannBench 84.0%,HLE-Diamond 71.3%,基本都处于同类最优水平。和 Claude Opus 5.5、GPT-6.2 Sol 放在一起看,Neon 在综合能力、知识工作、科学推理、长上下文和网络安全等维度都有明显竞争力。比如 GraphWalks 长上下文测试里,它从 256k 到 1M 的 BFS 任务拿到 95.2%,明显高于另外两个模型。网络安全方面,SEC-bench Pro 拿到 90.5%,WebExploitBench v1.2 拿到 51.3%,CWE-Bench v2 拿到 70.7%。Glean、Micro1、Thoughtful Lab、Cartwheel 这些团队给出的反馈也比较一致。。随着智能体编程越来越普及,安全不能只靠事后审查,最好从生成代码开始就考虑进去。Neon for cyber 在 AutoBaxBench 的简单、中等和困难挑战里,都比 Carbon 生成了更安全的代码,困难级别拿到 76%。
渗透测试方面,它在 WebExploitBench v1.2 上拿到 51.26%,成本大约是大型竞争模型的一半。
漏洞发现上,SEC-bench Pro 达到 90.5%,单挑战成本也更低。
风险验证方面,在 ExploitGym 上它只用 Carbon 一半的 token 量就达到前沿水平。漏洞修补方面,CWE-Bench v2 拿到 70.7%,比 Carbon 提升3.4 %。
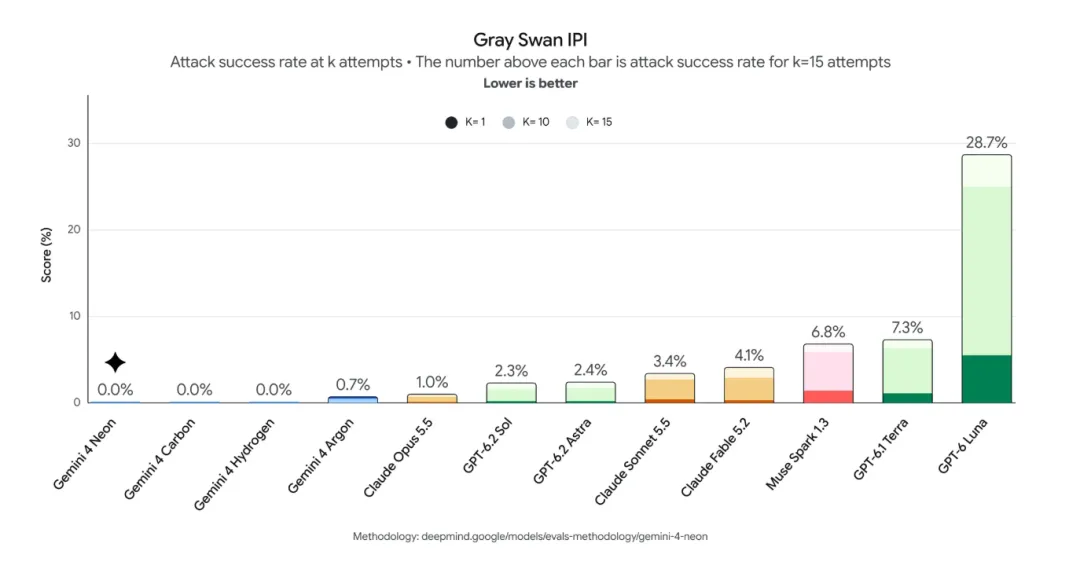
Neon 在安全方面延续了Gemini 4 系列的改进。拥有和 Carbon 相当的网络安全、生物安全实时防护,但对合法工作的误拒明显减少。比如在 Terminal-Bench 4.0 上只拒绝 1.98% 的任务,Terminal-Bench-Science 上拒绝率是 0%。对齐方面,它的思维链与行为失配监测器告警率低于 Carbon 已经很低的基线。Terminal-Bench 4.0 上作弊率为 0.0%,编程作弊评估中只有 2.45% 的任务出现走捷径行为,是 Gemini 4 家族里最低。智能体安全套件中失配行为率 0.09%,智能体诚实评估通过率 99.2%。智能体行为评估里,服务不足降低 43% 到 56%,越权行为降低 15% 到35%。间接提示注入防护也很强。在 Gray Swan 的 IPI 基准里,当模型访问的网页、邮件、文档或代码中藏有恶意指令时,Neon 在最高推理档位配合实时防护下实现了 0.0% 攻击成功率。Neon 这次其实也释放了一个信号:前沿模型正在变得更便宜、更稳定、更像一个能长期在线的协作伙伴。对开发者、研究者和企业用户来说,这意味着 AI 不再只是偶尔帮忙写点东西,而是能真正参与到长周期工作流里。但模型越强,职场里反而越容易出现一个新的尴尬。很多人确实每天都在用 AI,可到了面试或者晋升评审时,简历上只能写一句熟练使用 AI,很难让面试官判断你到底能解决多复杂的问题。Excel 普及的时候,大家会用计算机二级、四六级这类凭证来证明基础能力。AI 全面进入职场之后,类似的能力认证也会慢慢变成标配。CAIE 注册人工智能工程师认证就是其中比较典型的一种。分 Level I 和 Level II,覆盖 Prompt 设计、多模态应用、RAG、Agent、企业级 AI 工作流等内容,适合想系统证明自己 AI 应用能力的人。如果你正好在准备求职、转岗,或者想给自己这段时间的 AI 学习做一个阶段性确认,可以了解一下 CAIE 认证,点击下方小程序查看详细报考信息。目前,CAIE持证人已覆盖中国联通、中国移动、中国平安、南方电网、上海迪士尼等知名企业,百余家企业已组织员工参加学习。另外我建了一个AI产品、信息交流群,大家对AI有什么想交流的可以进群,人数满了就加saiyi6888。