我要认证
2026-02-04 阅读量:237
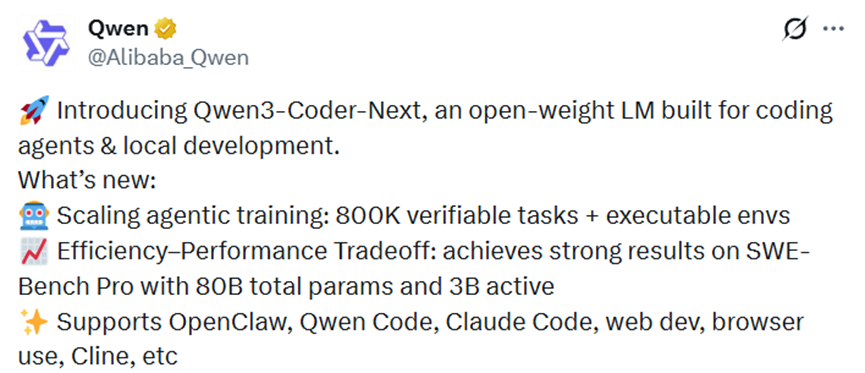
刚刚,阿里巴巴扔出了王炸开源Qwen3-Coder-Next,直接改写了编码AI的游戏规则。
这个模型的总参数一共有800亿,仅有30亿参数处于激活状态,可以轻松在本地部署,但性能却异常强悍。
开源地址:https://huggingface.co/collections/Qwen/qwen3-coder-next
https://modelscope.cn/collections/Qwen/Qwen3-Coder-Next
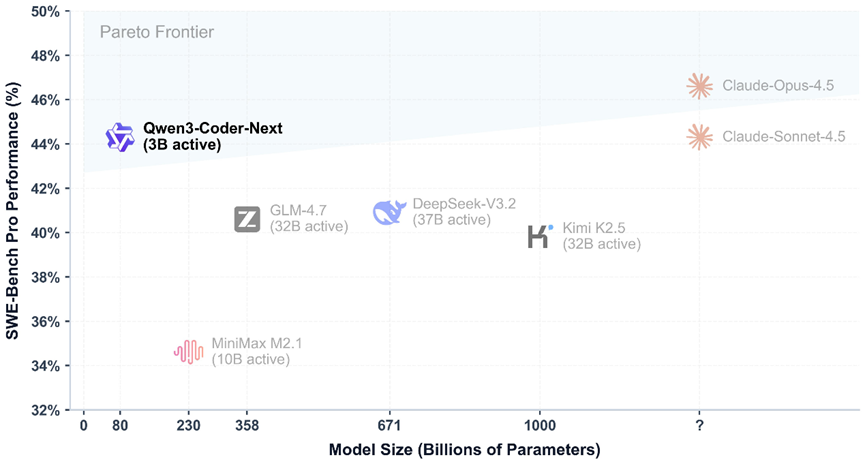
根据测试数据显示,Qwen3-Coder-Next在SWE-Agent、MiniSWE-Agent、OpenHands三大主流智能体测试中表现非常不错,分别取得70.6%、71.1%、71.3%的得分,比DeepSeek-V3.2、GLM-4.7、KimiK2.5更强。
因为它仅使用了30亿参数,而这三个参数在320亿和370亿,同时可以比肩闭源顶级编程模型Claude-4.5。
在通用知识与推理测试中,Qwen3-Coder-Next仍保持了强劲的通用能力。MMLU测试得87.73%,与通用模型Qwen3-Next87.87%几乎持平。
MMLU-Redux达91.18%,GPQA为74.49%,均略高于Qwen3-Next,显示出编码训练对通用推理的正向迁移效应。
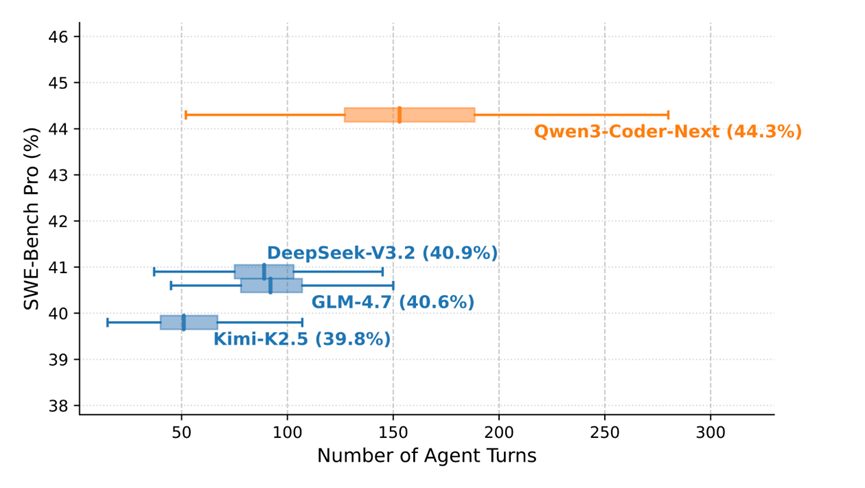
数学竞赛基准测试中,模型表现尤为突出,HMMT25Feb得70.21%、HMMT25Nov得75.57%、AIME24得89.01%、AIME25得83.07%。
相较于Qwen3-Next均实现10-16个百分点的大幅提升,验证了代码推理能力向数学推理的有效迁移。
Qwen3-Coder-Next的底子是Qwen3-Next,核心亮点就是混合注意力机制和MoE架构这俩组合拳。800亿参数只是它的知识库,里面藏着各种编程技能,但干活时只让最擅长当前任务的30亿参数出马。
其实Qwen3-Coder-Next最牛的不是架构,而是它的训练方式。以前的编程AI都是对着静态代码库死记硬背,就像只看菜谱不进厨房的厨师,知道步骤但做不出好菜。
而这个模型是在真实的编程环境里练出来的,从任务设计到训练执行,每一步都贴近实际开发场景。
要练出厉害的AI,得有足够多的真实任务。阿里团队用了两种方法攒素材,最后凑出了超80万可验证的编程任务,覆盖了Python、Java这些常用语言。
一种是从GitHub上扒真实的问题修复案例,把每个修复拆成有问题的代码、正确的解决方案和测试脚本三部分,还专门做了可运行的环境。
这样AI就能像跟着资深程序员学干活一样,知道实际开发中遇到的bug该怎么修。
另一种是在现有开源项目基础上造新任务,通过各种方式给正常代码注入可控的bug,还得保证这些bug能通过特定修复解决,确保AI练的都是有用的技能。
这么多任务要高效完成,得有靠谱的平台支撑。团队自己搞了个叫MegaFlow的系统,基于阿里云的Kubernetes搭建,能让海量任务并行运行。
这个系统把每个训练任务拆成三步,先部署AI和运行环境,让它们近距离配合减少延迟,再自动验证AI写的代码能不能跑通,最后整理结果供优化。
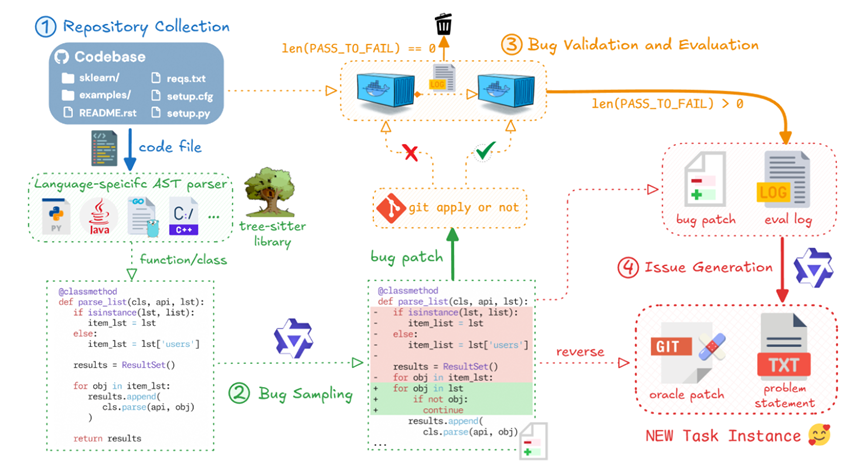
就像一个自动化的工厂流水线,不用人工干预就能让AI持续不断地练技能,效率直接拉满。
训练过程中,团队特别讲究数据搭配,主要用真实数据打基础,再加点合成数据补短板。
真实数据方面,不仅支持的编程语言从92种暴涨到370种,还把模型能处理的代码长度从3万多token提升到26万多,现在AI能轻松看懂整个代码库的结构,跨文件的依赖关系也能理清。
合成数据则分了两种,一种是简单的问答,让AI练基础知识点;另一种是多轮交互任务,模拟实际开发中一步步解决问题的过程。而且团队还优化了训练方式,避免AI学些没用的重复内容,让每一次训练都能学到真东西。
基础训练完成后,团队又做了三步升级。首先是监督微调,让AI学会听懂人类指令,还过滤掉那些没用的、跑不通的代码,保证训练质量。
然后针对性训练了四个专家模型,分别负责网页开发、用户体验优化、单轮问答和复杂软件工程任务,每个专家都在自己的领域做到极致。
最后通过技术把四个专家的能力融合到一个模型里,就像把四个顶尖高手的技能集中到一个人身上,既能搞定网页开发,又能处理复杂的工程问题,不用切换模型就能应对各种编程场景。
Qwen3-Coder-Next的出现确实改变了行业规则,并不是模型的参数越大就越强,找对训练方法和高质量数据才是关键。
想转型AI,不被时代淘汰
CAIE注册人工智能工程师认证
岗位能力 × AI工具 ×转型方向 × 场景落地 = 新AI职业价值
扫码免费领取《AI工程师入门学习指南》