我要认证
2026-08-19
现在做AI智能体的小伙伴们经常遇到一个头疼的问题,就是AI记不住之前说过的话,想找点资料像在黑箱里瞎摸。
要不就是把记忆、知识、技能散落在各个角落,用起来费劲还费钱。每个对话都要重新喂一遍背景信息,token烧得心疼,响应速度也慢得让人着急。
今天介绍一个字节跳动团队开源的OpenViking,超29000星曾经拿过Github每日最佳来解决这个大难题。

开源地址:https://github.com/volcengine/OpenViking
你可以把OpenViking理解成AI专用的超级大脑图书馆,能把记忆、资源、技能统统一股脑塞进一个虚拟文件系统里。要用的时候翻目录就能找到,不用在茫茫数据海里捞针。
研发团队在在LoCoMo这个长对话用户记忆测试上跑了三组实验,结果相当经验。用了OpenViking之后,三个不同AI集成的准确率全部冲到80%—83%。而原本自带的记忆系统准确率只有24%到57%。
更离谱的是Token消耗。在准确率暴涨的同时,输入Token数下降了34%—91%,查询延迟降低了58%—66%。

还有个在tau2-bench多轮任务测试上的数据,加了这个记忆机制之后,任务成功率比不带记忆的纯大模型,零售场景提升了6.87%,航空场景提升了11.87%。
兼容性也不错,Claude Code、Cursor等热门开发平台都有现成的插件,LangChain、LangGraph这样的框架也能无缝衔接。接着咱们在聊聊OpenViking有哪些好用的特色功能。
统一文件系统管理上下文
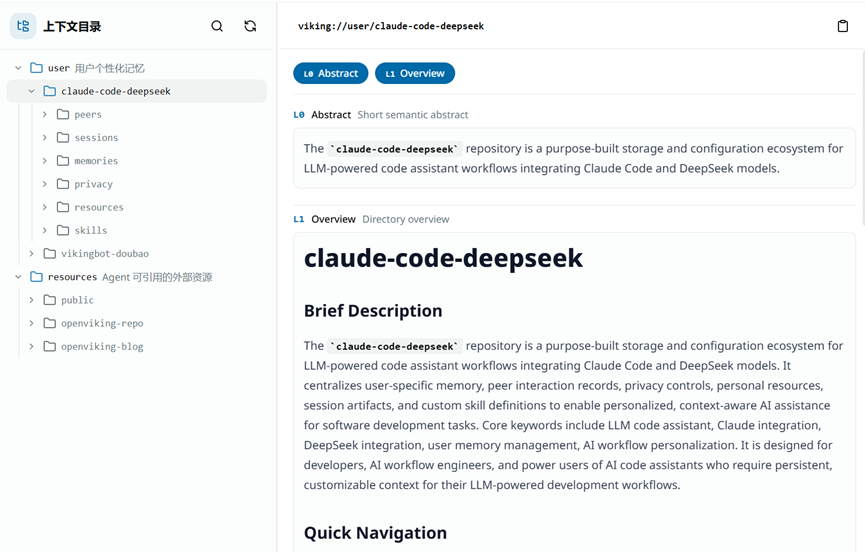
记忆、知识、技能都有自己专属的viking://地址,就像给每本书编上了索书号。AI想找什么资源,直接像程序员操作文件一样精准定位,再也不会像无头苍蝇一样到处乱撞。
你想让AI记住你的代码风格、项目文档,或者某个常用功能模块,统统都能安安稳稳住进这个统一仓库里。

三层分级加载帮省token
这个功能真的很绝,也是OpenViking能节省大量token原因之一。每一份上下文都会被自动处理成三个层级。
L0是一句话摘要,大概100个Token,用来快速判断这内容跟当前任务有没有关系。
L1是概览,大概2000个Token,包含核心信息,够Agent做规划决策用了。L2才是完整原文,只有真正需要细读的时候才加载。
这就像看书,你不会一上来就逐字逐句读完整本百科全书吧?你先看目录,再看章节概要,最后才翻开具体那一页。
AI也一样,没必要每次都把全部信息灌进上下文窗口。实测下来,Token消耗降了80%以上,有些场景甚至到91%,这对跑长任务、多轮对话的团队来说,省下来的可都是真金白银。
目录递归检索保持语境完整
向量搜索不是孤立地找单个文件,而是先定位最相关的目录,然后一层层往下钻。这样检索出来的内容带着上下文,就像完整的一章书而不是零散几页。
AI理解起来更连贯,不会拿着断章取义的信息瞎猜。你问项目某个功能,返回的不仅是那段代码说明,还能顺带把相关文档和案例一起带回来。
检索过程全程可追踪
每次查询的路径都会被完整记录下来,就像给AI装了思维轨迹记录仪。发现返回结果不对劲,你可以精准查看到底是哪个环节出了岔子。
这种透明度特别适合需要调试和优化的场景,不再面对黑箱干着急。
会话自动沉淀为长期记忆
对话结束后,系统会异步提取用户偏好和代理经验,自动转存进长期记忆库。你跟AI说过的习惯、项目里踩过的坑、常用的解决方案,都会被悄悄收纳起来。
下次遇到类似场景,AI直接从记忆里调取经验,不用从头聊起。这种自我进化的能力让AI越用越顺手。
我觉得OpenViking挺适合正在开发AI智能体的,需要管理大量上下文知识的项目团队。还有希望优化AI记忆能力的各种应用场景。
如果你也在为AI记不住东西、找资料费劲、token烧得太快这些问题烦恼,那OpenViking绝对值得一试。
想系统掌握AI核心技能、获取行业认可资质?
CAIE注册人工智能工程师认证
助你拓宽职业赛道,成为AI领域持证实力派
企业、高校及渠道合作
请联系微信:FYLlaoshi