登顶开源模型第一!DeepSeek V4.1-Flash量化版开源,128G内存本地就能跑
2026-10-20 阅读量:5
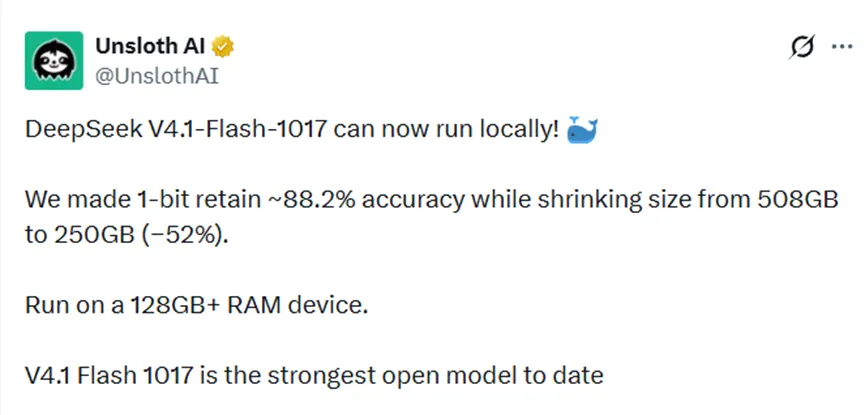
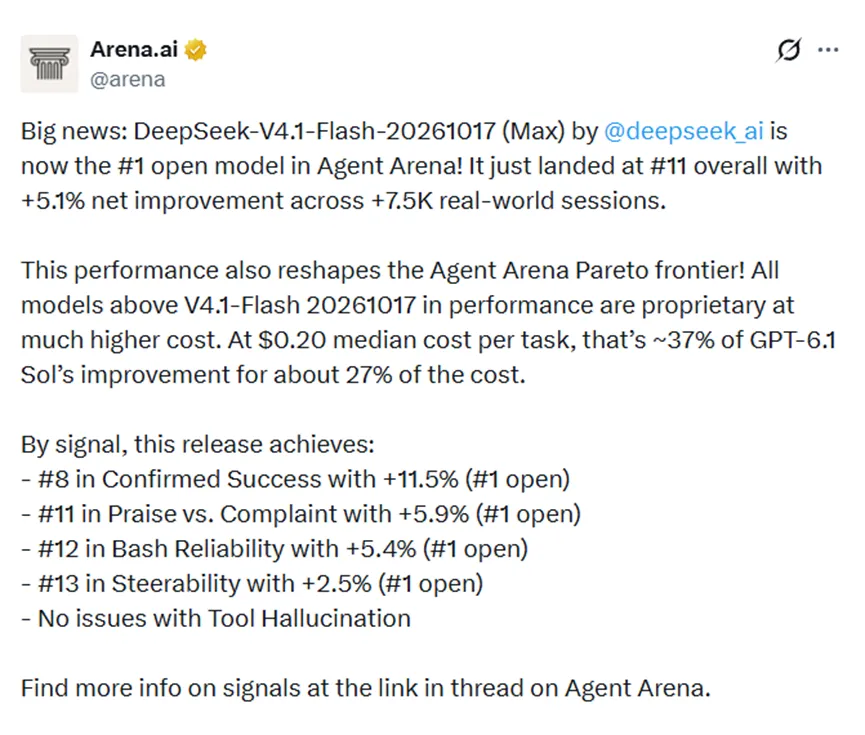
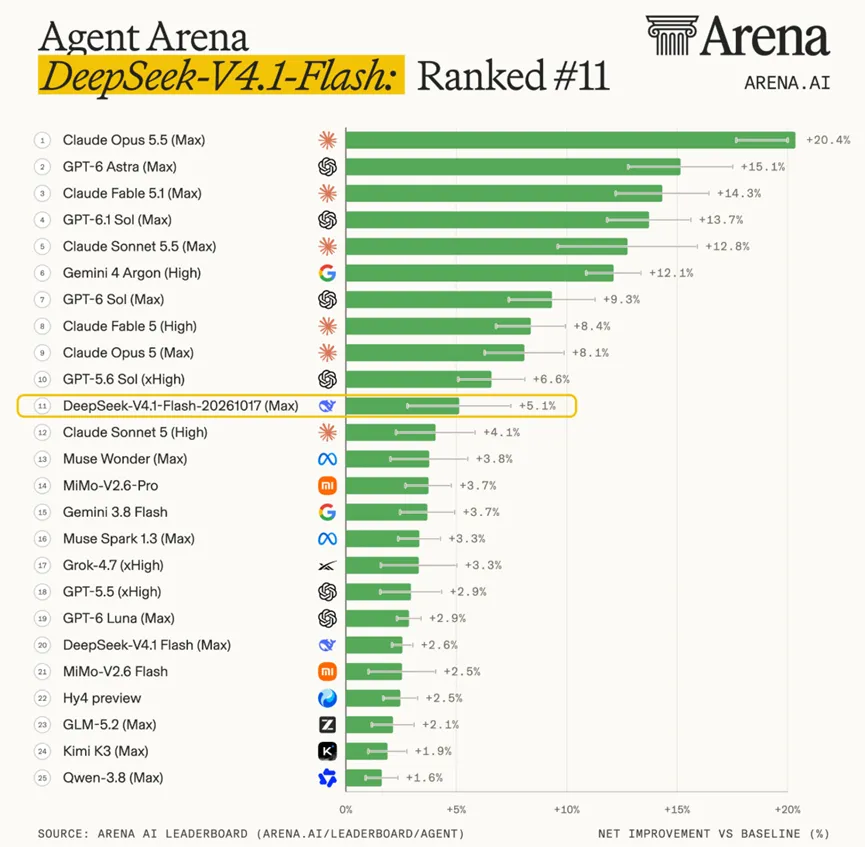
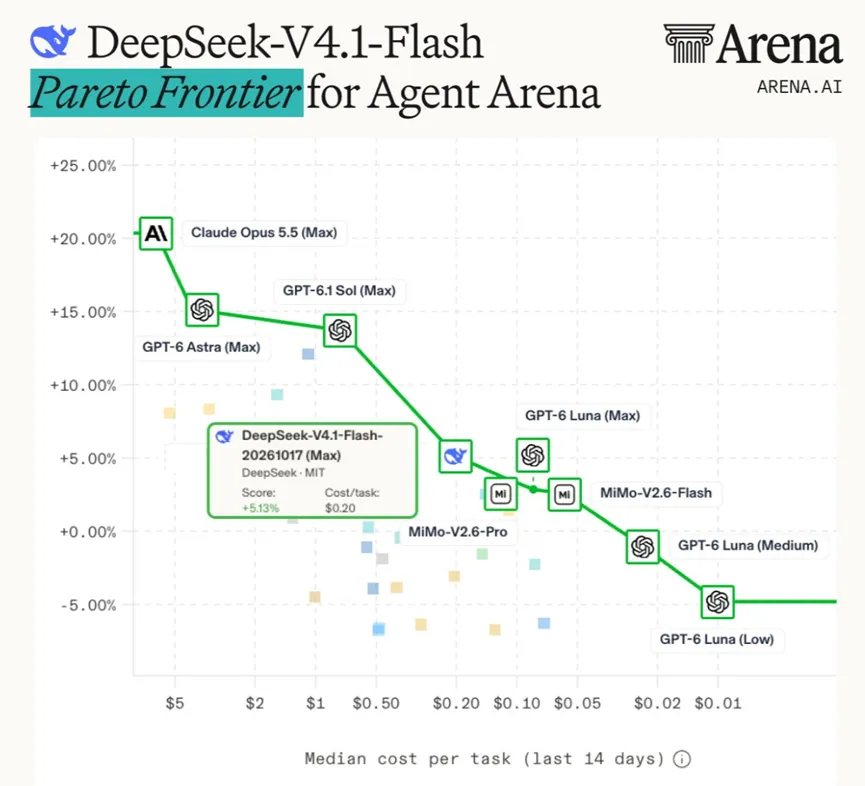
著名大模型优化平台Unsloth AI开源了,DeepSeek V4.1-Flash-1017最新量化版。V4.1-Flash-1017总参数达到7630亿,这种体量的大模型基本只能在专业服务器上运行,普通人想本地部署非常难。而这次推出的量化版本,把硬件门槛打下来了,只需要128G内存,就能在本地跑起当前综合实力最强的开源大模型。量化版开源地址:https://huggingface.co/unsloth/DeepSeek-V4.1-Flash-1017-GGUF而大模型竞技场Arena.ai公布了最新榜单,DeepSeek V4.1-Flash-1017拿下了开源模型第一的位置。整体大榜单排在第11名,在7500多场真实场景的对局里净提升5.1%。任务实际成功率排第8,提升11.5%,开源模型里第一名;用户好评差评比排第11,提升5.9%,开源模型里第一名;Bash命令执行稳定性排第12,提升5.4%,开源模型里第一名;指令可控度排第13,提升2.5%,开源模型里第一名。这个成绩也直接改写了Agent Arena的帕累托最优曲线。所有性能比V4.1-Flash-1017强的,都是闭源商用模型,使用成本也要高出一大截。核心优化亮点
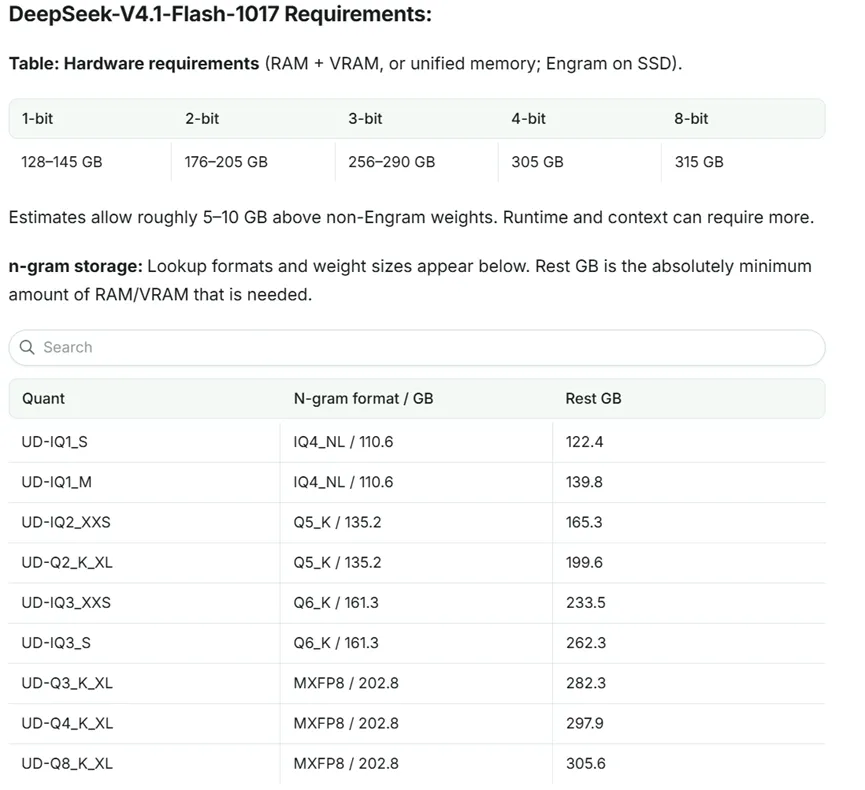
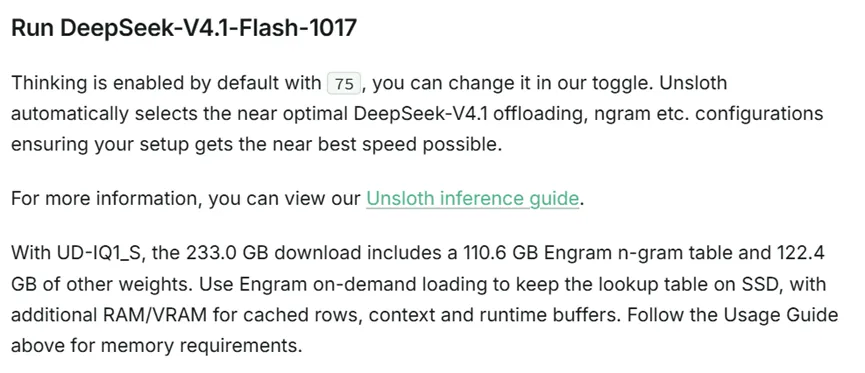
Unsloth这边做了挺多优化,推理速度能到同类项目3倍左右。实际跑下来加载和响应都挺跟手,没有那种等半天没反应的情况。1bit的UD-IQ1-S版本磁盘占用233GB,其中110.6GB是查表模块,剩下122.4GB是模型主体。跟官方原版的首token匹配度能到82.8%,这个数字放在1bit量化里已经挺能打了。要是设备内存到256GB这个档位,可以看看3bit的UDIQ3XXS,匹配率能拉到94.6%到96.8%这个区间,日常用基本感觉不出跟原版的差别。量化版本怎么选,其实看两个参数就够了。一个是磁盘占用,一个是top1匹配率。UDIQ1M比IQ1S只多了17.4GB,但wiki1100的匹配率提升了4.3%,长文本那边也涨了3.1%。再往上看,UDQ4KXL和UDQ8KXL之间差了7.7GB磁盘,匹配率只差0.3和0.2个%。要是你对精度没有特别极致的追求,Q4这个档位性价比很高。简单来说,最省事的1比特版本,128GB内存就能跑起来适合普通人,像MacBook、DGXSpark这些都能试。想跑效果更好的版本,256GB可以跑3比特版本,MacStudio那类机器刚好够。再往上要4比特、8比特,就需要305到315GB内存了。两种部署方式,新手优先桌面端
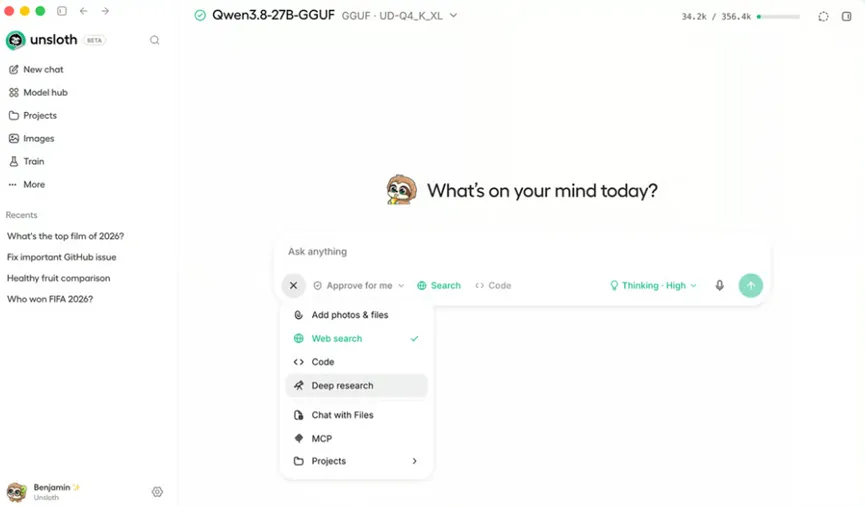
部署这块,Unsloth Desktop对新手很友好。macOS、Windows、Linux都有客户端,界面里搜模型、选量化版本、调参数,点几下就完事了。自动配置卸载和n-gram参数这个功能挺省心,不用自己去试各种组合。喜欢命令行的也可以用curl脚本装,Docker镜像也有。llama.cpp原生跑的话需要拉一个特定的PR分支,编译的时候注意AppleMetal设备把CUDA关掉就行。启动命令里那个loadmodemmap和lazymodeon两个参数别漏了,这是实现SSD按需加载查表模块的关键。思考强度默认是75,属于高挡位,模型会想得比较深。往低了调可以到1,往高了能到100。名字叫thinkingeffort,但它不是限制输出长度,而是控制推理的投入程度。想让它快速给个答案就调低点,要做复杂任务就拉满。关掉思考能力也有对应开关,灵活度挺高。还自带一个叫DSpark的加速功能,原理是派个小模型先帮你多猜几个词,大模型再核对改错,生成速度能再提升1.3—1.5倍。想用这个,得多下载一个配套的小草稿模型,也就8GB左右再预留点内存就行。AI工具快速迭代的当下,咱们也需要看清自身能力边界。如果你想评估自己的 AI 相关能力能不能匹配业务需求,可以试试下面这个AI思维素养测评小程序。短短几分钟完成测试,生成 AI 职业画像,评估 AI 思维水平和岗位替代风险。这套题目有一定难度,就算长期玩 AI 的老手,也很难拿到满分。看清自身真实能力,才能在 AI 浪潮里找准定位,平稳应对行业变化。
另外我建了一个AI产品交流群,大家对AI有什么想交流的可以进群,人数满了就加saiyi6888。