我要认证
2026-11-04 阅读量:2
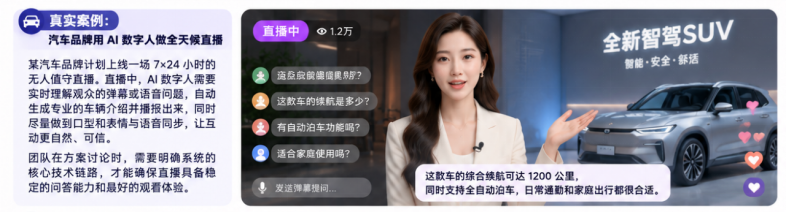
真实案例:汽车品牌准备让数字人主播全天候在线
某汽车品牌计划上线一间全天候直播间,希望通过AI 数字人持续介绍车型、配置、空间表现和品牌活动。观众进入直播间后,可以在弹幕中询问续航、智能驾驶功能或车型差异,也可以直接通过语音提出问题。系统需要理解这些问题,生成与车辆相关的回答,再由数字人自然地讲出来。
团队在测试时发现,数字人形象足够逼真,并不代表直播体验就完整。有的方案能够识别问题并把答案显示成字幕,数字人却没有同步开口;有的方案可以合成语音,但嘴型和表情与声音对不上;还有的方案依赖预录好的口型片段,遇到观众临时提出的新问题时,动作匹配就显得僵硬。
这类直播系统涉及多种AI 能力协同。它需要先理解观众输入,再生成合适的讲解内容,接着把文本转成语音,最后根据实际音频驱动数字人的口型和表情。只有这些环节衔接起来,才能形成较自然的实时互动体验。
解决办法:搭建“理解—生成—发声—驱动形象”的完整链路
1.接收并理解观众问题。观众输入通常有两种形式:文字弹幕和语音提问。弹幕本身已经是文本,可以直接进入后续语言理解环节;语音问题则需要先经过自动语音识别(ASR),将声音转换成可处理的文本。
2.由大语言模型生成回答。识别后的语音文本与观众发送的弹幕,都会进入大语言模型(LLM)。模型结合当前对话和直播任务要求,理解观众意图,并组织成自然、清晰的车辆介绍或问题答复。车辆参数、续航数据和配置差异等事实信息,实际系统还应结合经过审核的产品资料,减少错误讲解。
3.使用文本转语音(TTS)生成播报音频。LLM 输出的回答文本会交给 TTS,转换成数字人可以播报的语音。语音的音色、语速、停顿和情绪表达都会影响直播观感,因此需要与品牌主播的人设和讲解场景保持协调。
4.通过音频驱动口型和表情。系统将合成的语音音频输入音频驱动技术,例如Audio2Face 一类能力,生成与声音节奏相匹配的嘴型、面部表情或相关动作。这样数字人的视觉表现才能跟随实际播报内容变化,避免出现声音已经说完、嘴部还在动作的错位。
5.由数字人渲染引擎完成画面输出。驱动后的数字人形象与直播场景、车辆画面和必要的信息组件进行合成,再通过直播系统推送给观众。观众继续发送弹幕或语音问题,系统就可以进入下一轮理解和回答。
7×24 小时无人值守还要求系统持续监测输入、生成、语音和渲染等环节。遇到无法确认的车辆信息、识别失败或服务异常时,应有明确的兜底策略,例如提示观众稍后再问、转人工客服或切换到预设内容。
将真实场景转化为一道CAIE 练习题
某汽车品牌计划用AI 数字人做 7×24 小时无人值守直播讲解,要求数字人能实时理解观众弹幕或语音问题、自动生成车辆介绍并播报出来,同时尽量做到口型和表情与语音同步。以下哪项最符合这种数字人直播系统的主干链路?
A. 自动语音识别(ASR)+ 检索问答系统 + 实时字幕叠加,只要字幕同步显示在数字人旁边,观众就会自然感知为它在讲解。
B. 大语言模型(LLM)+ 实时动作生成 + 数字人渲染引擎,只要形象足够拟真,就可以在没有语音理解链路的情况下完成直播讲解。
C. 自动语音识别(ASR)+ 大语言模型(LLM)+ 文本转语音(TTS)+ 音频驱动口型/表情技术(如 Audio2Face 一类能力)。
D. 大语言模型(LLM)+ 文本转语音(TTS)+ 预录口型素材拼接,通过匹配最接近的嘴型和表情片段即可满足实时问答。
答案解析:C
C 正确:无人值守数字人直播需要形成“理解输入—生成回答—发声—同步驱动面部”的完整闭环。语音问题先由 ASR 转成文本,弹幕文字可以直接输入 LLM;LLM 负责理解和生成回答,TTS 将回答文本转换成语音,音频驱动口型/表情技术再让数字人的嘴型和表情与播报声音同步。
排除A:ASR 和检索问答能够帮助系统识别问题、组织答案,字幕叠加也能展示文字内容,但这条链路缺少回答转语音以及语音驱动数字人面部的关键环节,难以形成自然的数字人播报。
排除B:LLM 可以生成讲解文本,动作生成与渲染可以呈现数字人形象,但方案缺少完整的语音输入理解和语音输出链路。仅有形象与动作,无法完成观众提问后的实时语音回答。
排除D:LLM 与 TTS 能生成回答文本和语音,但预录口型素材拼接难以覆盖任意实时回答的语音节奏、发音和表情变化。面对开放式问答,音频驱动方式更适合实现连续同步。
这道题对应的能力:理解多模态AI 系统的协同工作流
从CAIE LEVEL Ⅰ 的学习与实践角度看,这个场景可以联系多模态应用与 AI 工作流拆解能力。面对一个完整的数字人直播任务,需要识别输入端、语言理解与生成端、语音输出端以及视觉呈现端分别承担什么工作,再判断这些模块是否形成完整闭环。
ASR、LLM、TTS 和音频驱动技术各有明确分工,单独某个模块表现优秀,也无法替代整条链路的协同。理解各模块的输入、输出和衔接关系,有助于判断方案是否真正满足实时互动需求。
提示词示范:规划汽车品牌AI 数字人直播方案
你是一名AI 数字人直播系统方案设计顾问。请为汽车品牌设计一套支持 7×24 小时无人值守讲解的直播方案。
业务目标:数字人能够理解观众发送的文字弹幕和语音问题,生成准确、自然的车辆介绍并播报,同时尽量实现口型和表情与语音同步。
请按以下结构输出:
1. 系统主干链路,说明 ASR、LLM、TTS、音频驱动口型/表情技术和数字人渲染的作用及先后关系;
2. 文字弹幕与语音提问分别如何进入系统;
3. 每个模块的输入、输出和需要关注的关键指标;
4. 如何保证车辆参数、配置和活动信息的准确性;
5. 如何处理识别失败、模型无法回答、语音合成异常或渲染中断等情况;
6. 给出端到端测试清单,覆盖提问理解、回答质量、语音自然度、口型同步和长时间运行稳定性。
请用流程图式文字说明模块关系。对尚未确定的工具或技术选型请标注待评估,不要虚构系统已经具备的能力。
这段提示词把业务目标、系统模块、输入输出和异常处理都列清楚,适合用来生成方案初稿。真正部署时,还需要结合品牌已有的车辆知识资料、直播平台接口、数字人形象授权和系统稳定性要求进行验证。
结语
AI 数字人直播的体验,取决于从观众提问到数字人开口回答的每一个环节。ASR、LLM、TTS 和音频驱动技术各自承担不同任务,只有链路衔接顺畅,才能让直播间具备实时理解、自然播报和面部同步能力。对于 7×24 小时无人值守场景,还要持续关注回答准确性、异常兜底和长时间运行稳定性。
如果你也想系统提升自己分析AI 应用场景、拆解技术方案并设计多模态工作流的能力,可以点击下方小程序,完成一次 AI 应用能力测评,了解自己的能力特点,并获取相应的学习路径建议。
👉 完成测试后,还可领取 《 CAIE LEVEL 考试大纲》 与更多实战练习题