我要认证
2026-07-03 阅读量:678
按住下方图标,点击小程序
免费领取AI学习资料、精选提示词
咱们用传统的文字转语音工具出来的声音又干又机械,听着跟念课文似的,完全没有感情。
而请真人配音呢,价格贵得离谱,一句话几十块,一段视频下来成本高到让人心疼。
今天介绍一个曾拿过Github每日最佳,超59000星的开源TTS利器GPT-SoVITS。
这个模型最强的一点就是5秒钟克隆你的语音,只需要1分钟语音素材就能精调,对于咱们没有大量语音数据的普通用户来说太方便了。
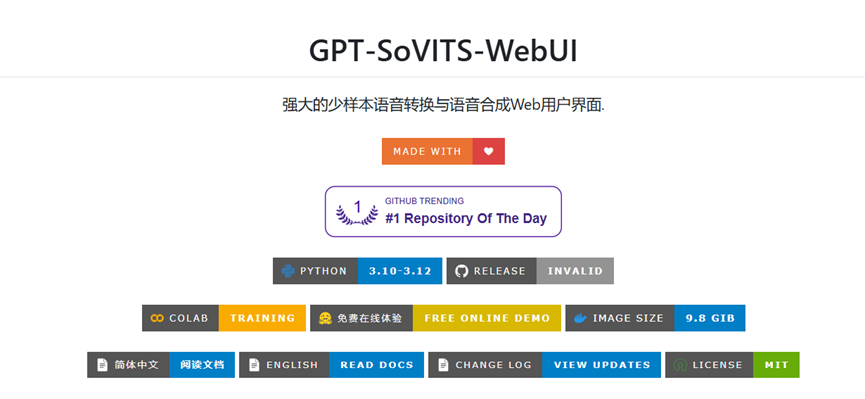
开源地址:https://github.com/RVC-Boss/GPT-SoVITS
然后说下GPT-SoVITS的主要特色功能。第一个不得不提的功能就是0样本语音合成。你只需要提供大概五秒钟的人声样本,这个工具就能立刻开始把文字转成语音。
你在网上听到一段特别好听的声音,截取五秒钟丢进去,输入你想说的文字,马上就能得到一段用那个声音朗读的语音。
这个功能特别适合那种临时需要某个人声音的场景,比如你想给某个梗视频配个音;
或者想试试某个名人念一段搞笑台词的效果,几分钟就能搞定,完全不需要事先准备什么训练数据。
案例展示
但五秒钟的样本毕竟有限,如果你想要更逼真、更像本人的效果,那就得用到少样本语音克隆功能了。
一分钟的录音其实很好准备,随便找个人念一段文字录下来就行。这个功能对于有更高要求的创作者来说很友好。
比如你想做一个固定的虚拟主播形象,或者想给你的频道设计一个专属的旁白声音,训练一次以后就能反复用,效果还特别稳定。
还有一个狠强大的功能是跨语言推理。什么意思呢,就是你拿中文语音训练出来的模型,可以直接让AI用日语、英语、韩语甚至粤语来朗读文字。
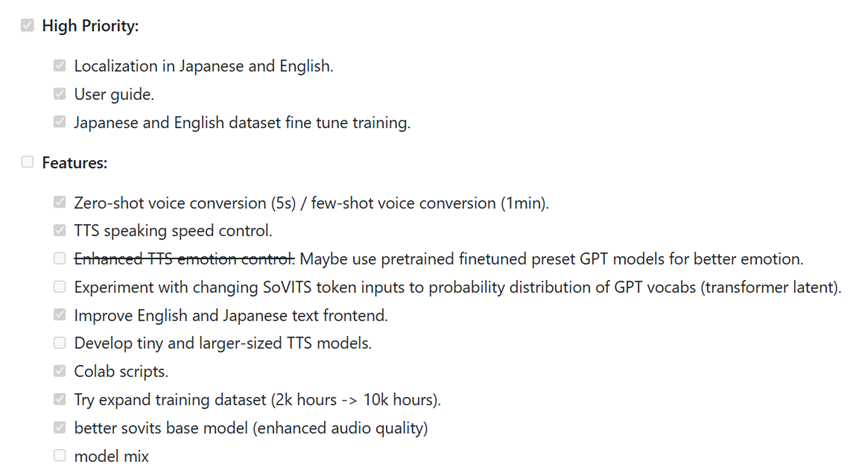
这在以前是不可想象的,因为传统方法通常是每种语言都要单独训练一个模型,费时费力。现在你只需要一个模型,就能实现多语言输出,对于做跨国内容的朋友来说,这个功能会很爽。
除了核心的语音合成功能,这个项目还集成了一堆实用的小工具。比如人声伴奏分离,能把歌曲里的人声和背景音乐拆开;
自动训练集切片,能帮你把长录音自动切成适合训练的小段;还有中文语音识别和文本标注功能,能帮你快速整理训练数据。
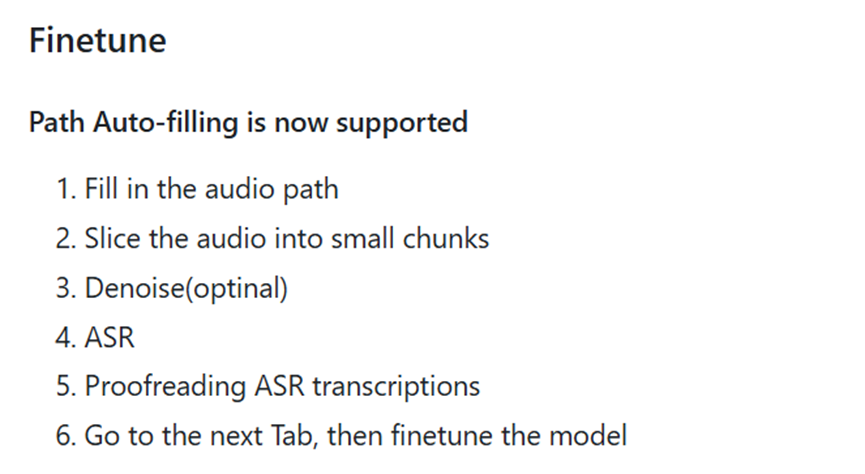
这些工具对于新手来说特别友好,因为做语音克隆最难的一步其实不是训练模型,而是准备数据,这些工具把这个门槛也给你降低了。
除了基础的语音克隆之外,我觉得把这个工具和虚拟主播结合起来,实现了文字实时转语音的功能。
主播只需要打字,虚拟形象就能用训练好的声音实时说话,这对于不方便出声直播的场景特别实用。或者直接用来做有声小说,也挺有意思的。
说实话,以前这种级别的语音克隆,多数都是大公司把持着不开放,或者商用价格高得离谱。
现在有了这个项目,普通人也能玩转语音合成,不管你是做内容创作、做游戏开发,还是纯粹出于好奇想试试,都值得一试。
企业、高校及渠道合作
请联系微信:FYLlaoshi