我要认证
2026-07-14 阅读量:683
按住下方图标,点击小程序
免费领取AI学习资料、精选提示词
平时刷博物馆线上展厅不知道大家有没有同款糟心体验,点开 三D 文物模型提问,AI 讲解员经常说得头头是道。
可回头去查馆藏资料全对不上,引用失效网页,遇到史料有争议的古董还乱给定论。
北大、北京交通大学等研究团队联合开源了一个AI博物馆VaseMuseum,不用改动大模型底层权重,仅靠推理阶段多层校验就能大幅降低AI胡编乱造的幻觉问题。
开源地址:https://github.com/AIGeeksGroup/VaseMuseum
其实咱们平时玩那些多模态大模型,让AI看图说话感觉挺厉害的,但真要把它们放到专业的博物馆里当导游就很难用。
想一下,古希腊陶器的解读哪是看一眼图就能搞定的,那得研究容器形状、彩绘场景、制作工艺、年代学还有出土地点这些特别专业的东西。
很多时候游客问的问题,光靠看外表根本答不上来,必须得去查历史文献或者考古资料。
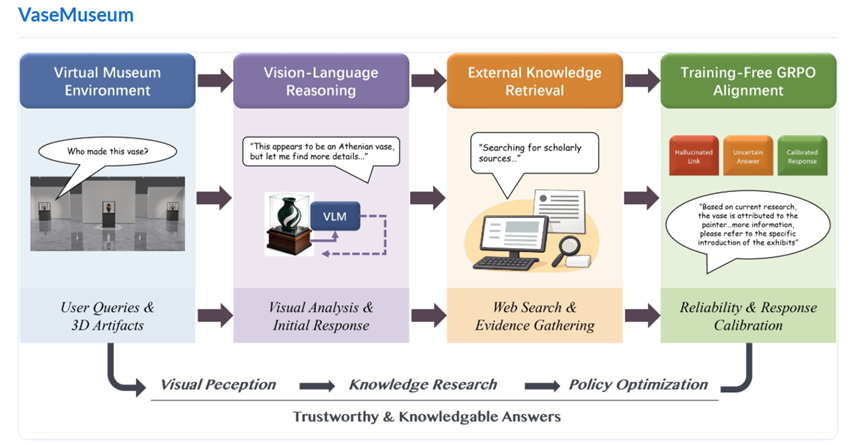
为了解决AI在导读文物时可能出现的错误情况,研究团队在开发VaseMuseum时换了一个思路,把博物馆导览当成一个寻找证据的过程。
整个系统大概可以拆成几个核心部分,虚拟交互环境负责展示文物,视觉推理模块负责看图说话,外部知识获取模块负责出门找资料,可靠性控制模块则像个监工一样盯着整个过程不让AI瞎搞。
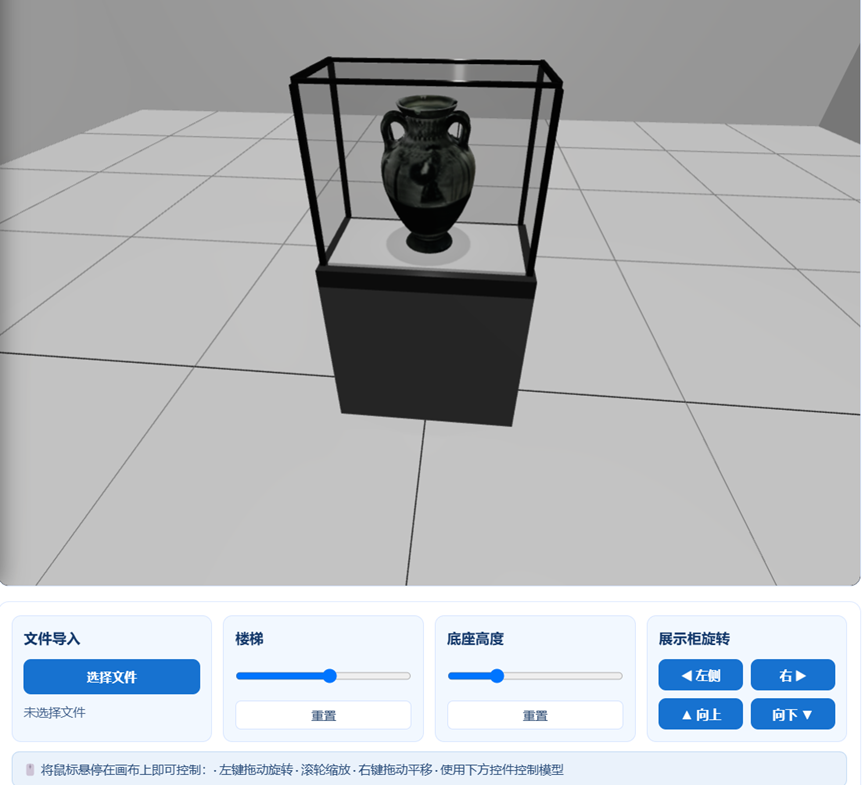
大家可以在虚拟环境里自由放大看陶器的高清图甚至三维模型,然后随便提问。系统里的核心智能体收到问题后,会先自己分析画面里的陶器长什么样,画了什么人,用了什么手法。
要是发现光看图不够用,就会自动切换到查资料模式,去网上和博物馆数据库里捞信息。
两道硬核关卡专治AI胡说八道
捞回来的信息肯定不能直接信,所以研究者加了一道特别关键的关卡叫源头控制。大家可以把这想象成一个极其严格的图书管理员,在资料进入大脑之前先做一遍筛查。
这个管理员会检查每一条搜索结果的网址能不能打开,标题和摘要内容够不够充实,然后算出一个综合的及格线。只有网址可访问且内容足够的资料才会被保留下来,那些打不开的死链接或者干巴巴的短句直接就被踢出去了。
过关的资料还要再算一次预多样性分数,把那些跟问题不相关或者来源太水的统统丢掉。
为了避免看到好几篇内容差不多的文章浪费时间,系统用了一种叫最大边际相关性的算法,在保证内容相关的同时,尽量多找几个不同网站发出的声音,最后挑出五条最靠谱的资料打包整理好。
资料找齐了也洗干净了,接下来大模型就可以开始写答案了吧,别急,后面还跟着一个响应控制模块。这个模块的作用就是审核员,专门检查大模型写的草稿到底有没有真凭实据。
审核员会把问题和草稿拆解成一个个小声明,然后挨个去证据池里找有没有资料能支持这些话。只要证据和声明的文字重合度超过一个很低的底线,就算这条证据支持了这个说法。
同时审核员还特别敏锐,如果发现两份资料内容很像但态度截然相反,比如一个说是公元前五世纪一个说是公元前四世纪,系统就会记录下这种冲突。
最后系统会综合有多少声明被证据支持了,有没有多个来源互相印证,以及存在多少冲突,算出一个总的置信度。
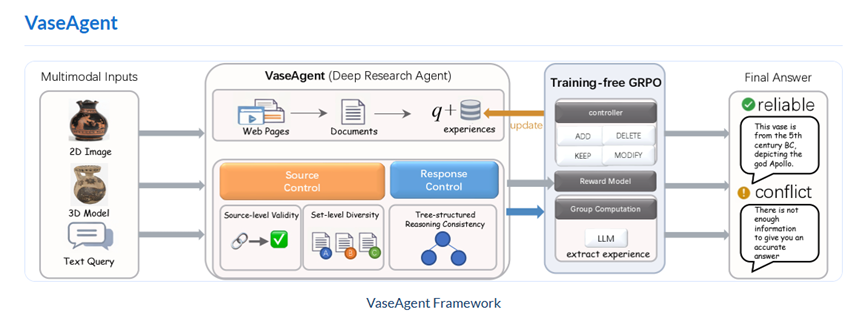
要是算出来的分数不及格,系统就会进入一种老实交代模式,回答的时候会主动加上一段声明,告诉用户这个问题目前还有争议或者证据不足,哪部分不能给出确定结论。如果分数够高,那就正常输出答案并且把审核记录留下来备查。
AI幻觉暴降
搞了这么复杂一套系统,到底效果怎么样呢,研究团队做了很严谨的测试。
他们基于之前的一个三维陶器图像集,挑了500多件能跟古典神话学词典数据库对上号的古希腊陶器,然后把这些陶器的记录跟各种学术资源对齐,补充了一大堆神话背景和考古资料进去。
测试的问题分成了三类,一类是光靠看图就能回答的纯视觉问题,一类是必须查资料才能答的视觉加知识问题;
还有一类是本身就有争议或者信息不全的模糊问题。他们拿通用大模型直接回答和开启搜索功能的版本来做对比。
结果出来确实让人眼前一亮。在那种最考验真功夫的视觉加知识问题上,完整版的系统把大模型乱编乱造的幻觉率从开启普通搜索模式时的44%硬生生压到了22%。回答有理有据的比例也从55%飙升到73%,中立性得分更是涨了一大截。
这充分说明在需要专业知识的复杂场景下,严加管教比放任模型自己去搜要靠谱得多。
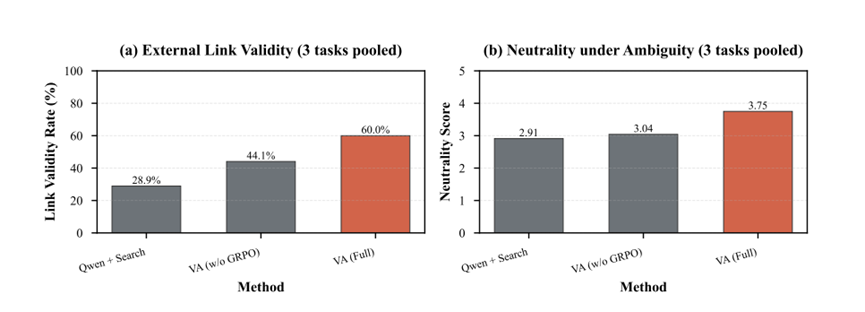
在引用链接可靠性这块更是夸张,普通带搜索的大模型给出来的网址有效比例为28.9%,加了源头和响应控制之后涨到了44.1%,加上刚才说的那个多路选择机制直接干到了60%。
遇到那些模棱两可的问题,系统也不再去抢着下断言,表现得更像一个懂行的策展人一样谨慎。
企业、高校及渠道合作
请联系微信:FYLlaoshi